에이전트란 무엇인가 What Is an Agent?
ChatGPT는 에이전트인가? 오늘은 1995년의 정의부터 확인하고, 지금의 도구들이 그 기준에 맞는지 따져 본다.
Introduction
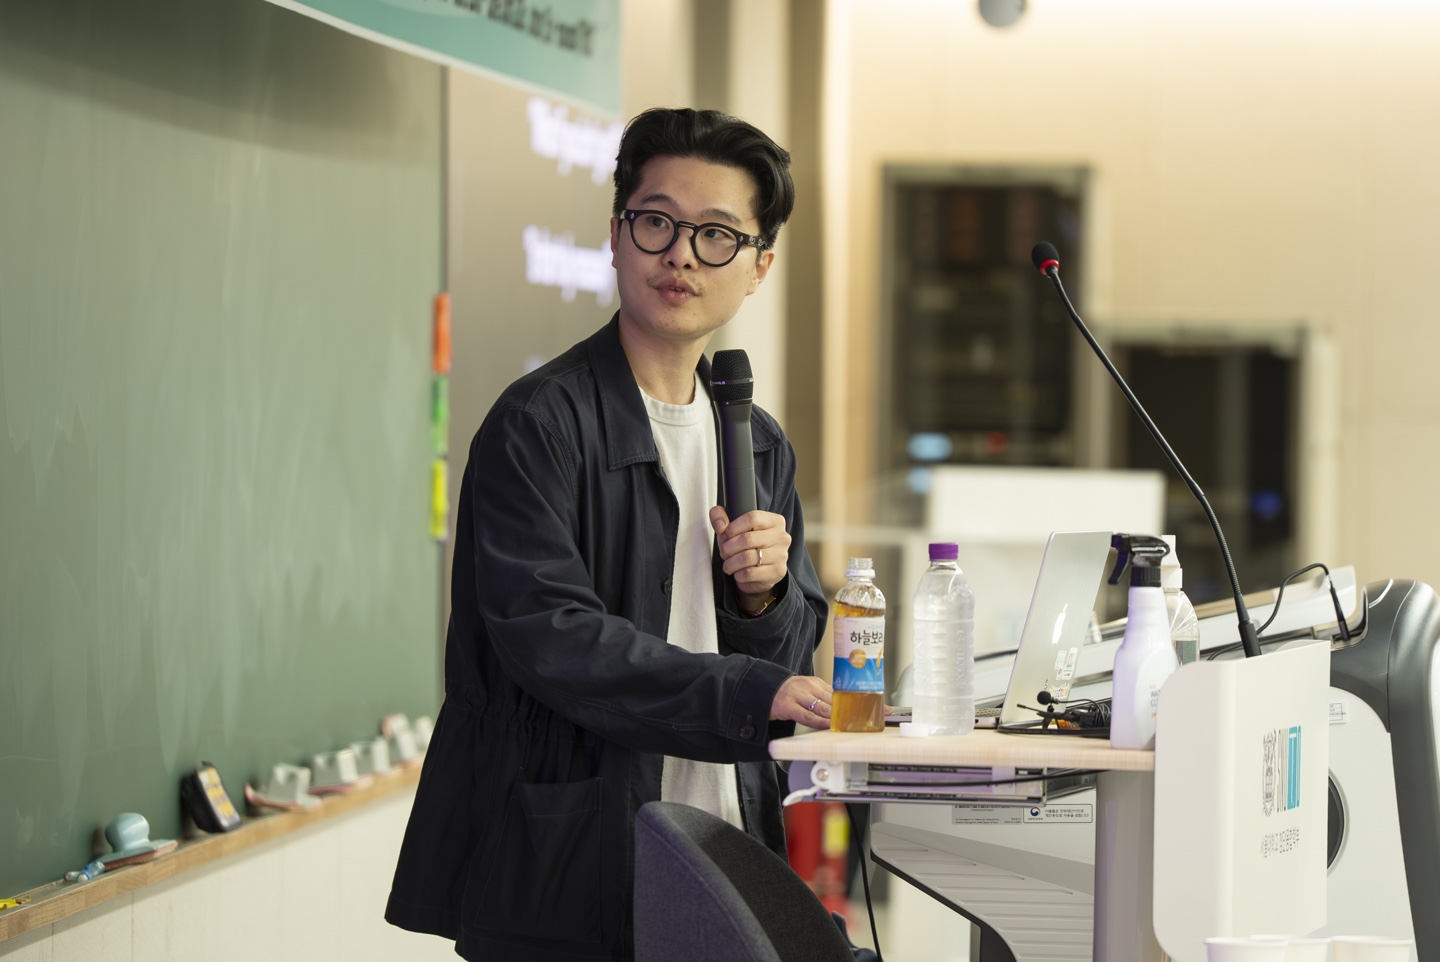
10년차 소프트웨어 엔지니어로, 지금은 ZEP에 있다. 이 수업이 열리는 서울과학기술대학교 대학원에서 석사를 마쳤고, 데이터 파이프라인과 분산 시스템을 연구해 BIGCOMP와 Frontiers in Big Data에 논문을 냈다.
ZEP에서는 400만 MAU 규모의 WebRTC 클러스터를 운영한다. LiveKit Cloud에 있던 이 클러스터를 OCI 자체 운영으로 옮기며 인프라 비용을 60% 줄였고, 그 과정을 Oracle Digital Native Roundtable에서 발표했다.
오픈소스 Agent OS인 Ouroboros를 만들고 있다. 인터뷰로 요구사항을 Seed로 확정하고, 실행 결과를 deterministic gate로 검증하는 에이전트 프레임워크다. ZEP QUIZ(월 60만 건 이상의 퀴즈)에는 도구를 스스로 개선하는 에이전트가 있다. 이 구조로 ICML 2026 AI×Education 워크숍에서 발표했다.
오늘의 구성
| 구분 | 내용 |
|---|---|
| A1 | 에이전트 정의의 역사 |
| A2 | 40년 계보: Contract Net에서 A2A까지 |
| A3 | LLM 에이전트 해부 |
| 토론 | The Bitter Lesson |
| LAB | 첫 에이전트 구축, 저장소 포크와 첫 PR |
에이전트란 무엇인가, 정의의 역사와 오늘의 재검증
에이전트 정의의 역사: 1995년의 두 가지 개념
오늘날 ‘에이전트’라는 말은 챗봇에도, 자동화 스크립트에도, 백그라운드 데몬에도 붙는다. 같은 단어로 서로 다른 것을 이야기하고 있으니, 어떤 시스템을 에이전트라고 부를지 판정할 기준부터 세워야 한다. 그 기준의 출발점은 Michael Wooldridge와 Nicholas Jennings가 1995년에 발표한 논문 “Intelligent Agents: Theory and Practice”다. 이 논문은 그때까지 마구 섞여 쓰이던 ‘에이전트’라는 용어를 두 개의 명확한 개념으로 정리했다. 이 구분은 30년이 지난 지금도 그대로 쓰인다.
첫 번째를 저자들은 약한 개념(weak notion)이라 부른다. 어떤 시스템을 에이전트라고 부르려면 최소한 네 가지 성질을 가져야 한다는 것이다.
약한 개념의 에이전트는 네 속성을 만족한다.
- 자율성(autonomy)
- 반응성(reactivity)
- 사전능동성(pro-activeness)
- 사회성(social ability)
M. Wooldridge & N. Jennings, “Intelligent Agents: Theory and Practice” (1995)
자율성이란 인간이나 다른 존재의 직접적 개입 없이 스스로 동작하고, 자기 행동과 내부 상태를 어느 정도 통제한다는 뜻이다. 매 단계 사람이 버튼을 눌러 줘야 움직이는 것은 도구이지 에이전트가 아니다. 반응성은 환경을 지각하고 그 변화에 시의적절하게 응답하는 능력이다. 환경은 계속 변하므로, 미리 짜 둔 순서만 재생하는 시스템은 반응적이라 할 수 없다. 사전능동성은 그 반대 방향의 성질이다. 단지 자극에 반응하는 데 그치지 않고 스스로 목표를 세우고 주도적으로 그 목표를 향해 행동하는 능력이다. 반응성만 있으면 수동적 반사에 머물고, 사전능동성만 있으면 환경 변화를 놓친다. 마지막으로 사회성은 다른 에이전트나 인간과 통신 언어로 상호작용하는 능력이다.
두 번째는 강한 개념(strong notion)이다. 주로 인공지능 연구자들이 쓰는 이 개념은, 위의 네 속성에 더해 인간에게나 어울릴 법한 정신적 속성들을 시스템에 부여한다. 대표적인 것이 믿음(belief), 욕구(desire), 의도(intention)로 이루어진 이른바 BDI 모델이다. 에이전트가 세계에 대한 믿음을 가지고, 이루고자 하는 욕구를 품으며, 그중 실제로 추구하기로 정한 의도를 갖는다고 보는 것이다. 여기에 지식, 나아가 감정 같은 속성을 얹기도 한다. 강한 개념은 에이전트를 하나의 지향적 시스템(intentional system)으로 다룬다. 즉 그 행동을 ‘저 시스템은 X를 믿기 때문에 Y를 하려 한다’는 식으로 설명하는 것이 유용해지는 대상으로 본다.
Wooldridge와 Jennings는 이 지향적 어휘를 설계와 분석의 도구로 쓰자고 강조했다. 복잡한 시스템의 행동을 물리적 수준이나 코드 수준에서 낱낱이 추적하는 대신, ‘믿음’과 ‘의도’라는 상위 어휘로 기술하면 예측과 설명이 훨씬 간결해진다. 우리가 LLM에게 “너는 사용자가 급하다고 판단했으니 가장 빠른 방법을 택하라”고 프롬프트를 쓸 때, 우리는 바로 그 지향적 어휘로 시스템을 설계하고 있다. 30년 전에는 이 어휘를 코드로 억지로 구현해야 했지만, 지금은 모델이 그 어휘를 이미 알아듣는다.
세 개념의 경계를 분명히 하기 위해, 저자들이 든 대조를 우리 식으로 확장해 보자. 프로그램은 입력을 받아 정해진 절차대로 출력을 낸다. 자율성도 반응성도 요구되지 않는다. 함수를 호출하면 값을 내놓을 뿐, 부르지 않는 한 아무것도 하지 않는다. 객체(object)는 여기서 한 걸음 나아가 상태와 행위를 캡슐화하고 메시지를 주고받지만, 그 메시지에 응할지 말지를 스스로 정하지 못한다. 다른 객체가 공개 메서드를 호출하면 객체는 그 요청을 수행해야 한다. 통제권이 호출하는 쪽에 있다. 반면 에이전트는 요청을 받고도 자기 목표에 비추어 응할지 거절할지를 판단한다. 이 차이를 저자들의 표현을 빌려 요약하면 다음과 같다.
어떤 시스템을 놓고 “이것은 요청받았기 때문에 하는가, 아니면 자기 목표에 부합한다고 판단했기 때문에 하는가”를 물으면, 그 시스템이 객체의 세계에 있는지 에이전트의 세계에 있는지가 드러난다. 오늘 실습에서 만드는 코드가 이 경계에 있다. while 루프 하나가 이 코드를 객체에서 에이전트로 바꾼다.
40년 계보: Contract Net에서 A2A까지
에이전트 통신의 역사는 대략 40년에 걸쳐 있다. 1980년대와 1990년대에는 야심찬 프로토콜들이 쏟아졌다. 2000년대에는 표준화가 진행되면서 오히려 조용해졌다. 2022년 이후에는 대형 언어모델과 함께 같은 문제가 다른 이름으로 다시 나타났다.
출발점은 1980년, Reid G. Smith의 Contract Net Protocol이다. 여러 처리 노드가 흩어진 분산 문제 해결 상황에서, 일을 어떻게 나눌 것인가라는 물음에 내놓은 답이었다. 관리자 역할의 노드가 할 일을 공고(task announcement)하면, 능력 있는 노드들이 입찰(bid)하고, 관리자가 낙찰(award)한다. 시장의 은유를 계산 자원 할당에 끌어들였다. 관리자와 계약자 역할은 태스크마다 동적으로 바뀐다. 이 프로토콜은 3주차 실습에서 LLM 에이전트로 재현한다.
1990년대에는 통신의 형식을 표준화하려는 시도가 무르익었다. KQML(Knowledge Query and Manipulation Language)과 이어진 FIPA-ACL(Agent Communication Language)이 그 결실이다. 이들은 언어철학의 화행 이론(speech act theory)에 기대어, 메시지에 ‘알림’, ‘요청’, ‘제안’ 같은 수행적 유형(performative)을 붙였다. 그러나 이 시도는 실패했고, 그 원인과 LLM이 그중 무엇을 해결하는지는 4주차에서 다룬다.
2000년대는 역설적으로 조용한 시기다. 표준 문서는 정교해졌지만 정작 널리 쓰이는 에이전트 생태계는 오지 않았다. 프로토콜은 있었으나 그 프로토콜을 채울 만큼 똑똑한 에이전트가 없었다.
전환점은 2022년, Yao 등이 제안한 ReAct다. 추론(reasoning)과 행동(acting)을 언어모델 안에서 엮어, 모델이 생각하고 도구를 쓰고 결과를 관찰한 뒤 다시 생각하는 루프를 만들었다. 이어 2024년 MCP(Model Context Protocol)는 모델과 에이전트가 도구와 컨텍스트에 연결되는 규격을 표준화했고, 2025년 A2A(Agent2Agent)는 자율 에이전트 사이의 발견과 태스크 위임을, ACP(Agent Client Protocol)는 코드 편집기와 코딩 에이전트 사이의 세션, 프롬프트, 도구 호출, diff, 권한 상호작용을 표준화하려 했다.
A2A의 agent card는 FIPA가 풀려던 발견 문제를 되살리고, ACP는 IDE마다 코딩 에이전트를 따로 통합해야 하는 N×M 문제를 공통 client-agent 경계로 줄인다.
LLM 에이전트 해부
“ChatGPT는 에이전트인가?”에 답하려면 먼저 LLM 에이전트가 실제로 무엇으로 이루어져 있는지 봐야 한다.
LLM 에이전트는 세 부분으로 이루어진다. 첫째는 모델이다. 텍스트를 받아 다음 텍스트를 내놓는 함수로, 그 자체로는 상태도 기억도 없고 외부 세계에 영향을 주지도 못한다. 둘째는 컨텍스트다. 모델에게 매 호출마다 건네는 입력 전체, 곧 시스템 프롬프트, 지금까지의 대화, 관찰된 결과, 사용 가능한 도구의 목록과 설명을 말한다. 모델은 컨텍스트에 들어 있는 것만 본다. 셋째는 도구 루프다. 모델이 “이 도구를 이런 인자로 부르겠다”고 출력하면, 바깥의 프로그램이 실제로 그 도구를 실행하고, 결과를 다시 컨텍스트에 얹어 모델을 또 부른다. 이 부르고 실행하고 되먹이는 순환이 멈출 때까지 반복된다.
LLM 에이전트 = 모델 + 컨텍스트 + 도구 루프.
이 수업의 작업 정의. W&J의 네 속성을 이 세 부품으로 구현한 것
자율성은 모델이 아니라 루프에서 나온다. 모델 한 번의 호출은 그저 프로그램이다. 입력을 넣으면 출력이 나온다. 그러나 그 출력을 받아 도구를 실행하고 결과를 되먹여 다시 부르는 while 루프를 씌우는 순간, 시스템은 스스로 다음 행동을 정하고, 관찰에 반응하며, 목표에 도달할 때까지 멈추지 않는 무언가가 된다. 이 루프는 실습에서 스무 줄로 직접 쓴다.
이제 W&J의 네 속성으로 LLM 에이전트를 채점해 보자. 자율성: 루프가 도는 동안에는 사람이 매 단계 개입하지 않는다. 다만 루프의 시작과 종료, 그리고 위험한 행동의 승인은 여전히 사람이 쥐고 있는 경우가 많다. 반응성: 도구 실행 결과가 컨텍스트로 되먹여지고, 모델은 그에 따라 다음 수를 바꾼다. 사전능동성: 목표를 프롬프트로 주면 모델은 중간 단계를 스스로 세운다. 이것이 ReAct가 준 능력이다. 다만 주어진 목표를 분해할 뿐, 새 목표를 세우지는 못한다. 사회성: LLM 에이전트끼리 신뢰할 수 있게 발견하고, 위임하고, 검증하며 대화하는 표준은 아직 완성되지 않았다.
| W&J 1995 속성 | LLM 에이전트 | 판정 |
|---|---|---|
| 자율성 | 루프가 도는 동안 개입 없음. 단 시작, 종료, 승인은 인간이 보유 | 부분 충족 |
| 반응성 | 도구 결과가 컨텍스트로 되먹여져 다음 수를 바꿈 | 충족 |
| 사전능동성 | 주어진 목표를 스스로 중간 단계로 분해 (ReAct) | 대체로 충족 |
| 사회성 | 에이전트 간 발견, 위임, 검증 표준 미완성 | 미충족 (이 수업의 주제) |
채팅창 안에서 사용자의 말에만 응답하는 기본 형태의 ChatGPT는, 엄밀히 말하면 반응적이지만 자율적이지도 사전능동적이지도 않다. 매 턴 사람의 입력을 기다리므로 루프의 주인이 사람이다. 이것은 대화 시스템이지 에이전트라고 부르기엔 미달이다. 그러나 같은 모델에 도구와 while 루프를 씌워, 즉 컨텍스트를 스스로 갱신하며 목표에 도달할 때까지 돌게 하면 약한 개념의 에이전트 자격을 대체로 갖추게 된다.
Richard Sutton은 2019년 에세이 “The Bitter Lesson”에서, AI의 70년 역사를 돌아보면 인간의 지식을 손으로 심어 넣은 방법들은 번번이 계산과 데이터의 규모(scale)를 앞세운 일반적 방법에 밀려났다고 주장했다. 탐색과 학습, 그리고 그것을 뒷받침하는 스케일이 결국 이긴다는 것이다. 이 주장은 이 수업의 전제와 정면으로 부딪힌다. 만약 스케일이 결국 모든 것을 해결한다면, 프로토콜과 계약과 검증을 공들여 연구하는 일은 시간 낭비가 아닌가?
- Sutton의 Bitter Lesson이 옳다면, 에이전트 사이의 통신 프로토콜(FIPA, MCP, A2A)도 결국 ‘손으로 심은 지식’에 불과해 더 큰 모델에 흡수될 운명인가? 아니면 프로토콜은 학습으로 대체될 수 없는 다른 종류의 문제인가?
- 신뢰, 부인 방지, 권한 위임의 범위 같은 것들은 ‘더 똑똑해지면’ 사라지는 문제인가, 아니면 아무리 똑똑한 에이전트라도 서로를 믿을 근거가 필요한 구조적 문제인가? 스케일로 지능은 키울 수 있어도 신뢰는 키울 수 없다면, 그 경계는 어디인가?
- Bitter Lesson을 이 수업의 ‘반면교사’가 아니라 ‘설계 원칙’으로 받아들인다면, 우리의 재현 실험은 무엇을 ‘손으로 심지 말아야’ 하는가? 프로토콜의 어느 부분을 모델의 상식에 맡기고, 어느 부분을 명시적 규칙으로 남겨야 하는가?
첫 에이전트: while 루프 + 도구 두 개
루프가 에이전트를 만든다
자율성은 모델이 아니라 루프에서 나온다는 것을 실습으로 확인한다. 계산기와 파일 읽기라는 도구 두 개를 모델에 쥐어 주고, 모델이 스스로 도구를 골라 부르고 결과를 관찰하며 답에 도달할 때까지 도는 while 루프를 만든다. 준비물은 Python 3.10 이상, anthropic 또는 openai 패키지, 그리고 API 키 하나다. 아래 예제는 표준 라이브러리와 anthropic 패키지만 쓴다.
- 도구 두 개를 파이썬 함수로 정의한다. 계산기는 문자열 수식을 받아 수를 돌려주고, 파일 읽기는 경로를 받아 내용을 돌려준다. 도구의 ‘설명’이 곧 모델이 읽는 인터페이스다.
- 모델에게 도구 목록을 컨텍스트로 건넨다. 각 도구의 이름, 설명, 인자 스키마를 넘긴다. 모델은 이 목록에 있는 도구만 안다.
- while 루프를 씌운다. 모델이 도구를 부르면 실행해 결과를 되먹이고, 모델이 최종 답을 내면 루프를 끝낸다.
- 종료 조건과 안전장치를 넣는다. 무한 루프를 막는 최대 반복 횟수, 그리고 파일 읽기 경로 제한 같은 최소한의 방어를 둔다.
import os, ast, operator, anthropic

# ---- 도구 1: 계산기 (eval 없이 안전하게) ----
_OPS = {ast.Add: operator.add, ast.Sub: operator.sub,
        ast.Mult: operator.mul, ast.Div: operator.truediv,
        ast.Pow: operator.pow, ast.USub: operator.neg}

def _ev(node):
    if isinstance(node, ast.Constant): return node.value
    if isinstance(node, ast.BinOp):
        return _OPS[type(node.op)](_ev(node.left), _ev(node.right))
    if isinstance(node, ast.UnaryOp):
        return _OPS[type(node.op)](_ev(node.operand))
    raise ValueError("허용되지 않은 식")

def calculator(expression: str) -> str:
    """수식 문자열을 계산한다. 예: '3 * (4 + 5)'"""
    return str(_ev(ast.parse(expression, mode="eval").body))

# ---- 도구 2: 파일 읽기 (작업 폴더 밖 접근 차단) ----
def read_file(path: str) -> str:
    """텍스트 파일의 내용을 돌려준다."""
    full = os.path.abspath(path)
    if not full.startswith(os.getcwd()):
        return "거부: 작업 폴더 밖 경로"
    with open(full, encoding="utf-8") as f:
        return f.read()[:4000]

TOOLS_IMPL = {"calculator": calculator, "read_file": read_file}

# ---- 모델에게 건넬 도구 스키마 (설명 = 인터페이스) ----
TOOLS = [
  {"name": "calculator",
   "description": "산술 수식을 계산한다.",
   "input_schema": {"type": "object",
     "properties": {"expression": {"type": "string"}},
     "required": ["expression"]}},
  {"name": "read_file",
   "description": "작업 폴더의 텍스트 파일을 읽는다.",
   "input_schema": {"type": "object",
     "properties": {"path": {"type": "string"}},
     "required": ["path"]}},
]

def run(goal: str, max_steps: int = 8):
    client = anthropic.Anthropic()  # ANTHROPIC_API_KEY 사용
    messages = [{"role": "user", "content": goal}]

    for step in range(max_steps):   # ← 이 루프가 에이전트를 만든다
        resp = client.messages.create(
            model="claude-sonnet-4-5", max_tokens=1024,
            tools=TOOLS, messages=messages)
        messages.append({"role": "assistant", "content": resp.content})

        if resp.stop_reason != "tool_use":   # 최종 답 → 종료
            return "".join(b.text for b in resp.content
                           if b.type == "text")

        results = []
        for block in resp.content:        # 도구 호출 실행 → 관찰
            if block.type == "tool_use":
                out = TOOLS_IMPL[block.name](**block.input)
                print(f"  [도구] {block.name}({block.input}) → {out}")
                results.append({"type": "tool_result",
                    "tool_use_id": block.id, "content": str(out)})
        messages.append({"role": "user", "content": results})

    return "중단: 최대 반복 초과"   # 종료 조건 = 안전장치

if __name__ == "__main__":
    print(run("notes.txt를 읽고, 거기 적힌 숫자들의 합을 구해줘."))
이 코드의 핵심은 for step in range(max_steps) 한 줄이다. 이 루프를 지우고 messages.create를 한 번만 부르면, 그 순간 시스템은 다시 프로그램이 된다. 도구를 부르겠다는 텍스트만 남고, 어떤 도구도 실제로 실행되지 않는다. notes.txt에 숫자 몇 개를 적어 두고 직접 돌려 보라. 모델이 먼저 read_file을 부르고, 그 결과를 보고 나서 calculator를 부른다. 이 두 번의 호출이 콘솔에 그대로 찍힌다.
SUBMIT저장소 포크와 첫 PR
이 수업의 모든 과제는 수업 저장소를 포크해 PR로 제출한다. 마감 판정은 PR을 연 시각 기준이다. 이 실습에서는 포크하고 첫 PR을 연다.
- 수업 저장소를 포크하고 클론한다. 저장소의 README와
AGENTS.md에 규칙 전부가 있다. 코딩 에이전트를 쓴다면AGENTS.md부터 읽히고 시작한다. - roster에 자기 파일을 추가한다.
roster/<학번>.md를 만들어 자기 GitHub 아이디를 적는다. - upstream으로 PR을 열고 자동 검사를 확인한다. Actions가 파일명과 GitHub 아이디를 대조한다. 검사가 통과하면 수업 중에 바로 머지한다. 이후 매주
submissions/<학번>/제출 검사는 이 파일의 아이디와 대조한다.
first_agent.py가read_file→calculator를 스스로 이어 호출하며 정답을 낸다.- 루프를 제거하면 도구가 실제로 실행되지 않음을 직접 확인했다.
- 포크에서 연 roster PR이 자동 검사를 통과했다.
- 최대 반복 횟수와 파일 경로 제한이 실제로 동작함을 확인했다.
제출 규칙은 매주 같다.
logs/에 파일로 커밋한다.LLM과 에이전트 도구는 모든 과제에서 자유롭게 써도 좋다. 단, 무엇을 시켰고 무엇을 버렸는지는 커밋 히스토리와 로그에 남아야 한다.
과제로 만든 코드와 프로젝트의 저작권은 만든 학생에게 있다.
과제
제출물: 실습에서 만든 첫 에이전트에 도구를 하나 더 추가하고, 그 에이전트로 실제 태스크를 해결한다. 새 도구는 무엇이든 좋다. 웹에서 텍스트를 가져오는 fetch, 현재 시각을 알려주는 clock, 간단한 메모를 파일에 쓰는 write_note 같은 것들이다. 도구가 하나 늘었을 때 모델의 도구 선택 행동이 어떻게 달라지는지 관찰한다.
형식: 포크의 submissions/<학번>/week-01/에 커밋하고 upstream으로 PR을 연다. (1) 실행되는 first_agent.py(도구 3개), (2) 새 도구를 왜 그렇게 설명했는지 한 문단(TOOLS.md), (3) 에이전트 실행 로그(logs/).
채점 기준: 코드가 실제로 돌아가는가(재현성)가 절반이다. 다른 사람이 여러분의 코드와 설정만으로 같은 결과를 낼 수 있어야 한다. API 키를 제외한 모든 설정(모델명, 도구 스키마, 실행 방법)을 명시하라. 나머지 절반은 무엇을 시도하고 무엇을 버렸는지가 커밋 히스토리와 로그에 솔직하게 남아 있는가다.
읽기자료
- 필수M. Wooldridge & N. Jennings, “Intelligent Agents: Theory and Practice” (1995)이 강의의 원전. weak notion의 네 속성과 strong notion의 구분을 원문으로 확인하고, 이 네 속성으로 스스로 LLM 에이전트를 다시 채점해 보기 위해.
- 필수R. Sutton, “The Bitter Lesson” (2019)토론 준비 자료. ‘스케일이 이긴다’는 주장을 직접 읽고, 그렇다면 프로토콜 연구는 왜 하는가에 스스로 답을 정해 오기 위해.
같은 모델인데 왜 결과가 다른가. 다음 주는 이 질문에서 시작한다. 결과의 차이는 루프의 설계, ‘하네스’에서 나온다. ReAct(Yao et al. 2022)를 읽고 컨텍스트 관리, 도구 granularity, 종료 조건, 에러 복구, 인간 개입 지점을 익힌다. 실습에서는 같은 태스크에 하네스 변형 두 가지를 A/B로 붙여 직접 측정한다.